2025. 9. 24. 16:51ㆍAI
저번에 정리한 LLM에 대해 정리한 내용에서 결국 LLM은 다음 단어를 잘 맞히도록 학습된 신경망이기 때문에 가끔 자신 있게 틀리는 환각현상이 발생한다고 했습니다. 그런데 이걸 알고 나면 자연스럽게 다음 질문이 생깁니다.
"그럼 회사 내부 문서나, 모델이 학습한 시점 이후의 최신 정보는 어떻게 답하게 하지?"
이 질문에 대한 가장 현실적인 답이 바로 이번 글의 주제인 RAG입니다.
이 글도 RAG가 무엇이고 내부에서 대략 어떤 일이 일어나는지를 큰 그림 위주로 정리한 입문적인 내용입니다.
RAG가 필요한 이유
RAG를 이해하려면 먼저 LLM이 못 하는 일을 이해해야 합니다.
- 모델은 학습한 시점까지의 지식만 알고 있다.
LLM은 학습이 끝난 순간 지식이 박제됩니다. 학습한 시점 이후에 나온 뉴스, 어제 배포한 우리 서비스의 정책 변경 같은 건 알 방법이 없습니다. - 모델은 우리 회사 내부 데이터를 모른다.
LLM은 당연하게도 우리 사내 위키, DB에 쌓인 상담 이력, 사내 규정 문서는 모델 학습 데이터에 들어있지 않습니다.
모델은 일반적인 세상 지식만 알지, 우리 회사에 대해서는 아무것도 모릅니다. - 모를 때 모른다고 하지 않고 그럴듯하게 지어냄. (환각현상)
지난 글에서 이야기했듯 LLM은 "정답을 외운 것"이 아니라 "다음에 가장 그럴듯한 말을 이어 붙이는" 모델입니다.
그래서 모르는 걸 물어봐도 모른다고 하기보다 그럴듯한 거짓말을 만들어내는 경우가 많습니다.
이 세 가지 문제를 모델을 다시 학습시켜서 해결하려고 하면 비용이 어마어마합니다.
게다가 내부 문서는 매일 바뀌는데 그때마다 모델을 새로 학습시킬 수도 없죠. 그래서 사람들은 발상을 바꿉니다.
"모델을 다시 가르치는 대신, 답할 때 필요한 자료를 찾아서 같이 쥐여주자"는 겁니다.
RAG란 무엇인가
RAG는 Retrieval-Augmented Generation의 약자입니다.
이름이 곧 동작 방식이라 풀어보면 이해가 쉽습니다.
- Retrieval(검색) : 질문과 관련된 문서를 외부에서 검색
- Augmented(보강) : 그 문서를 프롬프트에 같이 끼워 넣어 보강
- Generation(생성) : 모델이 그 자료를 근거로 답을 생성
한 줄로 줄이면 모델이 답을 생성하기 전에, 관련 자료를 찾아서 프롬프트에 함께 넣어주는 방법입니다.
가장 많이 드는 예시로는 오픈북 시험이 있습니다.
모델에게 세상의 모든 걸 외우게 한 뒤 시험을 보게 하는 대신, 시험을 볼 때 관련 페이지를 펼쳐서 책상 위에 올려주는 겁니다.
그러면 모델은 그 자료를 보고 답하면 되니까, 외우지 않은 내용도 정확하게 답할 수 있습니다.
여기서 중요한 점은 모델 자체는 전혀 건드리지 않는다는 것입니다. 파라미터를 다시 학습시키는 게 아니라, 그냥 입력 프롬프트에 참고 자료를 더 넣어주는 것뿐입니다. 우리가 평소에 ChatGPT나 Cluade한테 자료를 넣어주거나 텍스트를 복붙 해서 "이거 보고 답해줘"라고 하는 것과 본질적으로 같습니다. RAG는 그 "자료를 찾아서 붙이는 과정"을 자동화한 것이라고 보면 됩니다.
RAG는 어떻게 동작하는가
RAG는 크게 두 단계로 나뉩니다. 미리 자료를 정리해두는 단계(색인)와, 실제 질문이 들어왔을 때 처리하는 단계(검색·답변)입니다.
데이터 준비(색인)
데이터 준비 단계에서는 데이터를 수집/정제/임베딩하는 여러 단계가 포함됩니다.

- 데이터 수집
우선 신뢰할 수 있는 다양한 소스에서 비즈니스 요구사항과 부합하는 데이터를 수집합니다. - 데이터 추출 및 정제
데이터는 여러 형식일 수 있습니다. (텍스트 파일, 데이터베이스 테이블, PDF 등)
이 단계에서 불필요한 데이터를 제거하고 일괄된 형식으로 데이터를 표준화합니다. - 청크 분할
청크 분할은 데이터를 의미 있는 크기로 쪼개는 과정입니다.
우리가 모델에게 참고시키고 싶은 문서들(사내 위키, PDF, 규정집 등)을 잘게 쪼갭니다. 이 조각을 청크(chunk)라고 부릅니다.
데이터를 쪼개는 이유는 지난 글에서 다룬 컨텍스트 윈도우 때문입니다.
만일 문서 하나가 통째로 수십 페이지라면 프롬프트에 다 넣을 수 없습니다. 그리고 질문과 상관없는 부분까지 넣으면 토큰 낭비이자 모델이 정확한 답변을 찾는데 어려움이 있을 수 있습니다. 그래서 문단 단위 정도로 잘게 나눠두고, 나중에 질문과 관련된 조각만 골라 쓰는 겁니다. - 임베딩 및 벡터화
지난 글에서 어텐션을 설명할 때 "각 단어는 의미를 담은 숫자 벡터로 바뀐다"라고 했습니다.
임베딩이 바로 텍스트를 의미를 담은 숫자 벡터로 바꾸는 작업을 말합니다.
핵심은 의미가 비슷한 문장은 벡터 공간에서도 가까운 위치에 놓인다는 점입니다.
예를 들어 "강아지"와 "반려견"은 글자는 다르지만 의미가 비슷하니 벡터 공간상의 위치도 가깝습니다. - 인덱스 생성(저장)
이렇게 만든 청크 벡터들을 벡터 DB(Pinecone, Chorma, postgreSQL 등)에 저장해 둡니다.
우리가 평소에 쓰는 RDB가 "값이 정확히 일치하는 행"을 빠르게 찾도록 인덱싱 되어 있다면, 벡터 DB는 벡터값이 가장 가까운 데이터를 빠르게 찾도록 설계된 저장소입니다.
여기까지가 미리 해두는 색인 단계입니다. 질문이 들어오기 전에 한 번 만들어주는 작업입니다.
데이터 검색 및 답변
검색 단계
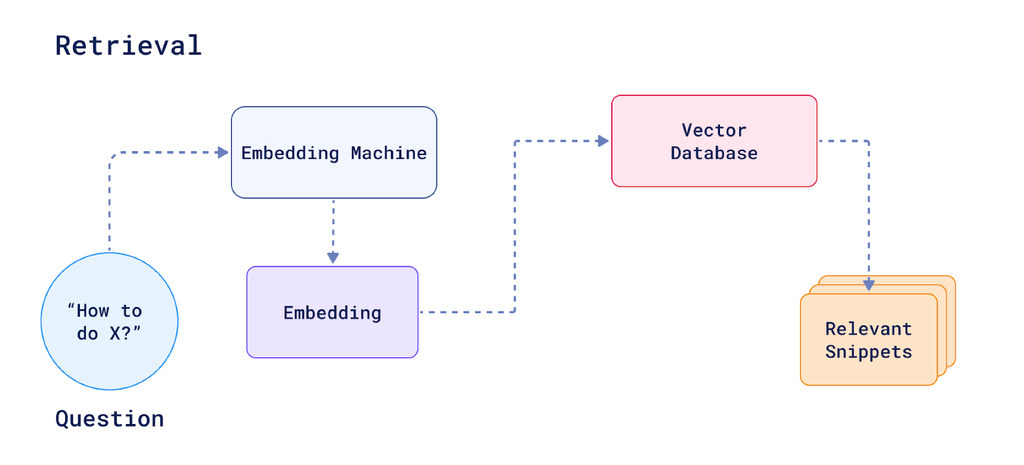
검색 단계에서는 사용자의 질문도 똑같이 임베딩해서 벡터로 바꿉니다.
(동일한 임베딩 모델을 사용해야 함.)
그리고 벡터 DB에서 이 질문 벡터와 가장 가까운 청크들을 찾습니다. 보통 가장 가까운 몇 개(top-k)를 가져옵니다.
벡터 DB 내에서는 벡터 간의 코사인 유사도(cosine similarity)나 유클리드 거리(Euclidean distance)를 사용하여 유사성을 계산하며, 이 과정을 통해 가장 관련성 높은 정보를 찾습니다.
생성 단계
생성 단계에서는 검색 단계에서 찾은 관련 청크들과 사용자의 질문을 합쳐서 하나의 프롬프트로 만들어 모델에 넘깁니다.
대략 이런 모양입니다.
[참고 자료]
- 환불은 7일 이내에 신청해야 합니다.
- 단순 변심의 경우 배송비는 고객 부담입니다.

위 자료를 근거로 다음 질문에 답하세요.
[질문] 환불은 며칠 안에 해야 해?
모델은 위와 같은 프롬프트를 받아서, 자기가 외운 지식이 아니라 눈앞에 주어진 자료를 근거로 "환불은 7일 이내에 신청하셔야 합니다"와 같은 답변을 생성합니다.
여기까지가 RAG의 전체 흐름입니다.
정리하면 문서를 쪼개서(청킹) → 벡터로 바꿔(임베딩) → 벡터 DB에 저장해 두고 → 질문이 오면 비슷한 청크를 검색해서 → 프롬프트에 붙여 → 모델이 답하게 한다.
추가로 알아두면 좋은 것들
- 검색 품질이 답변 품질을 결정한다.
RAG는 결국 "찾아온 자료"에 의존합니다. 엉뚱한 청크를 찾아오면 모델도 엉뚱하게 답합니다(garbage in, garbage out)
그래서 어떻게 관련 자료를 잘 찾아올까에 신경을 써야 합니다. - RAG도 환각을 100% 없애주진 않는다.
자료를 줘도 모델이 자료를 무시하고 엉뚱하게 답하는 경우가 있습니다.
그래서 프롬프트를 단단히 잡아줘 환각을 최대한 방지하는 것도 중요합니다. - 비용이 많이 발생할 수 있다.
문서를 임베딩하는 비용, 벡터 DB 운영 비용, 그리고 매 질문마다 청크를 프롬프트에 끼워 넣으니 토큰도 더 들어갑니다.
무작정 많은 자료를 넣기보다 꼭 필요한 만큼만 검색해서 넣는 게 성능·비용 양쪽에 좋습니다.
마무리
RAG는 글의 초반에서 LLM이 모르는 것도 그럴듯하게 지어내고 학습 시점 이후나 우리 내부 데이터는 알지 못한다고 했던 한계들을 모델을 다시 학습시키지 않고도 자료를 붙여주는 것만으로 상당 부분 메워줍니다.
다만, RAG를 사용한다고 해서 완전한 해결이 아닌 트레이드오프가 있다는 것도 반드시 알아둬야 합니다.
https://aws.amazon.com/ko/what-is/retrieval-augmented-generation/
RAG란? - 검색 증강 생성 AI 설명 - AWS
검색 증강 생성(RAG)이란 무엇이며, 기업에서 RAG AI를 사용하는 방법과 이유, AWS에서 RAG를 사용하는 방법에 대한 내용입니다.
aws.amazon.com
'AI' 카테고리의 다른 글
| Jev 알아보기 (0) | 2026.09.24 |
|---|---|
| 하네스 엔지니어링 (0) | 2026.04.03 |
| 바이브 코딩 체험기 (1) | 2025.09.25 |
| LLM (0) | 2025.09.24 |