2026. 9. 17. 11:13ㆍ기타
시작하게 된 계기
어느 날 새벽, 운영 중이던 서버가 원인 모르게 종료되었고 로그를 열어보니 이런 게 찍혀 있었습니다.
[SpringContextShutdownHook] INFO ... Application availability state
ReadinessState changed from ACCEPTING_TRAFFIC to REFUSING_TRAFFIC
애플리케이션이 스스로 종료 절차에 들어가면서 "이제 트래픽을 받지 않겠다"고 상태를 바꾼 로그였는데
문제는 왜 종료됐는지 알 수 없었다는 것, 그리고 서버가 죽은 걸 한참 뒤에야 알았다는 것이었습니다.
문제의식을 느끼고 모니터링 시스템 구축이 필요하다라 생각했고, 최초 모니터링 요구사항으로 아래의 2가지를 구현하였습니다.
- 서버가 비정상 상태가 되면 즉시 알림을 받고 싶다.
- 문제가 생겼을 때 원인을 파악할 수 있는 근거(지표, 로그) 가 남아있으면 좋겠다.
모니터링 시스템 구성
처음엔 "모니터링 도구 하나 깔면 되는 거 아닌가?" 싶었는데, 실제로는 역할이 다른 여러 도구를 조합하는 구조라는 걸 알았습니다.
검색해 본 결과 흔히 쓰는 오픈소스 조합은 아래와 같습니다.
| 도구 | 역할 |
| Node Exporter | 서버(OS)의 CPU·메모리·디스크 사용량을 수집·노출 |
| Blackbox Exporter | 앱이 응답하는지(살아있는지) 확인 |
| Prometheus | 위 데이터들을 주기적으로 가져와 저장하는 창고 |
| Alertmanager | 저장된 값이 규칙을 어기면 알림을 발동·전달 |
| Grafana | 저장된 데이터를 대시보드로 시각화 |
모니터링 시스템 흐름
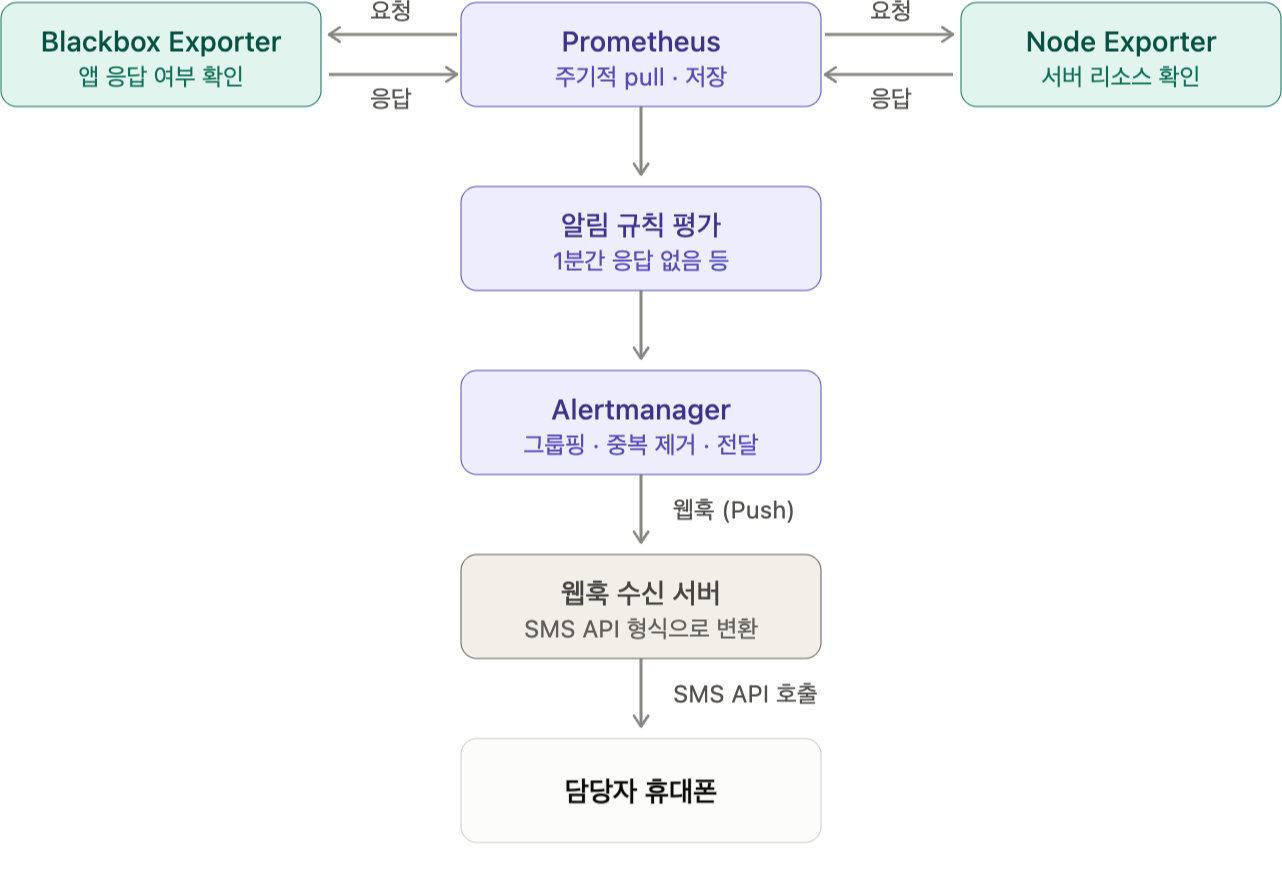
모니터링 흐름은 아래 순서로 흘러갑니다.
- Prometheus가 주기적으로 Blackbox Exporter와 Node Exporter에 요청(pull)
- 요청을 받은 Exporter가 그 시점의 메트릭을 측정해서 응답
- Prometheus는 받은 값을 저장하고 규칙을 평가, 규칙을 위반하면 Alertmanager에 알림을 전달
- Alertmanager는 알림이 오면 웹훅 서버로 요청을 전달
- 웹훅 서버는 요청을 받으면 SMS API를 호출해서 담당자 휴대폰으로 문자 전송
Prometheus
Prometheus는 이 모니터링 구성의 중심으로 Prometheus가 Exporter에서 데이터를 가져옴으로써 모니터링 로직이 시작됩니다.
[Node Exporter] → OS 메트릭을 줌
      ↑
      │  Prometheus가 주기적으로(예: 15초마다) 가지러 옴
      │
[Prometheus] → 가져와서 저장
Prometheus 혼자서는 아무 데이터도 없어서 다른 곳에서 메트릭을 노출해줘야 합니다.
- OS 리소스를 보고 싶으면 → Node Exporter
- 앱이 죽었는지 보고 싶으면 → Blackbox Exporter
- 앱 내부 상태(DB 커넥션, JVM 등)를 보고 싶으면 → Spring Boot Actuator
그래서 위처럼 각각 다른 Exporter가 필요합니다.
Prometheus 형식(exposition format)
여기서 Exporter들이 메트릭을 노출할 때는 Prometheus 형식이라는 정해진 텍스트 규칙을 따릅니다.
# HELP jvm_memory_used_bytes 사용 중인 JVM 메모리
# TYPE jvm_memory_used_bytes gauge
jvm_memory_used_bytes{area="heap"} 5.24288e+07
구조는 메트릭이름{라벨="값"} 숫자값으로 매우 단순합니다.
Prometheus 생태계 안에서 Exporter가 이 통일된 형식으로 노출하기 때문에, Prometheus는 상대가 누구든 똑같은 방식으로 긁어올 수 있습니다.
Alertmanager
Prometheus가 "규칙을 위반했다"라고 판단하면 Alertmanager로 알림을 넘깁니다.
그러면 여기서 다음과 같은 의문이 생깁니다. "왜 Prometheus가 직접 알림을 보내지 않고 Alertmanager를 따로 두었을까?"
이는 알림은 단순히 "보내기"만 하는 게 아니기 때문입니다.
- 그룹핑: 비슷한 알림을 하나로 묶는다.
- 중복 제거: 같은 알림이 반복되어도 한 번만 보낸다.
- 재알림 주기: 해결되지 않은 알림을 얼마 간격으로 다시 보낼지 정한다.
- 라우팅: 알림의 종류에 따라 보낼 곳(Slack, 메일, 웹훅 등)을 나눈다.
이런 전달 정책을 Alertmanager가 맡고, Prometheus는 판단에만 집중하는 구조입니다.
단계별 계획
모니터링 도입은 단계별로 할 예정이며 단계는 아래와 같습니다.
- 1단계: 감지 + SMS 알림
- 2단계: Grafana 대시보드 연결 — 장애 시 들어가서 원인을 눈으로 확인
- 3단계: Actuator 도입 — 앱 내부 상태까지 정밀 감지
'기타' 카테고리의 다른 글
| Prometheus 서버 모니터링 구축하기 (2) - 설치부터 SMS 알림까지 (0) | 2026.09.30 |
|---|---|
| Java PKIX path building failed 트러블슈팅 (0) | 2026.06.18 |
| Interpreter, Compile (0) | 2025.07.09 |
| S3 고아 객체 처리하기 (0) | 2025.05.16 |
| [React] PrivateRoute 구현 (0) | 2025.02.21 |